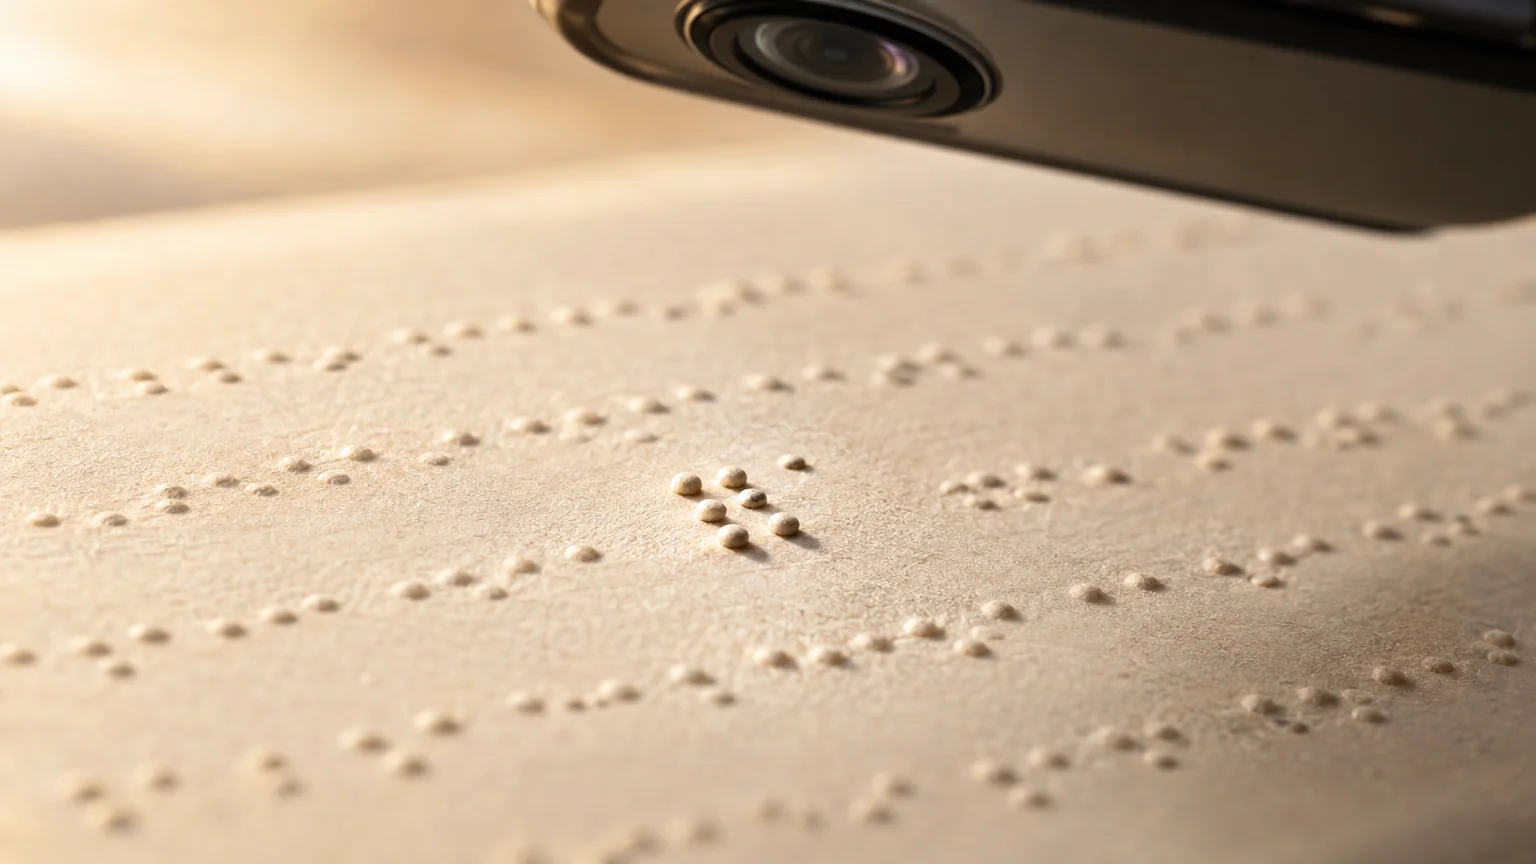
Punktkirjapilti lugenud tehisaru asendas ühes lõigus väljendi „like to” („meeldib … teha”) sõnaga „cannot” („ei saa”). Koos sõnadega muutus lause mõte. Nii eksis isegi mudel, mida oli spetsiaalselt punktkirja lugema õpetatud ning mis edestas katses kõiki eraldi töötanud üldotstarbelisi pildi- ja keelemudeleid.
Punktkirja mittetundval inimesel võib sellist viga olla väga raske märgata. Vastus võib olla ladus ja usutav, kuid selle kontrollimiseks tuleks osata lugeda kirja, mille mõistmiseks tehisaru appi võetigi. See on oluline näiteks õpetajale, kes kontrollib õpilase tööd, või pereliikmele, kes soovib lugeda punktkirjas teadet.
India teadlaste katse näitab siiski, et olukorda saab märgatavalt parandada. Lisatreeninguks kasutati pilte, millest mitte ühtegi polnud kaameraga tehtud: need kõik loodi arvutis. Tulemus osutab võimalusele õpetada tehisaru punktkirja täpsemalt lugema, kuid ei tõesta veel, et valminud oleks usaldusväärne igapäevane abivahend.
Kaamera peab nägema seda, mida sõrmed tunnevad
Punktkirjas määrab tähenduse punktide täpne asukoht. Tavapärases kuuspunktis on kaks tulpa, kummaski kolm võimalikku punktikohta. See, millised neist on täidetud, eristab üht märki teisest.
Fotol pole nende kohtade tuvastamine sugugi lihtne. Väikeste reljeefsete kühmude nähtavus sõltub valgusest, varjudest ja pildistamisnurgast. Sõrmedega loetav kiri võib kaamera jaoks taanduda nõrga kontrastiga mustriks.
Et mudelite oskust tegelikel piltidel kontrollida, koostasid Kartik Jangra ja kolleegid BrailleBenchi: 259 tegelikest allikatest kogutud punktkirjapilti, sealhulgas paberilehti, silte ja raamatulehekülgi. Iga pildi teksti kirjutasid sõltumatult ümber kaks märgendajat, kes seejärel vastuseid ristkontrollisid. Uurimus on avaldatud arXivis eelpublikatsioonina; kasutatud materjal ei kinnita selle eelretsenseeritust.
Katsetati ingliskeelse punktkirja kaht vormi. Lihtsamas kirjutatakse sõnad üldjuhul tähtede kaupa. Lühenditega vormis võib üks märk või märgijada tähistada tervet sõna või täherühma. Siis ei piisa üksnes punktide eristamisest: arvestada tuleb ka konteksti.
Parim eraldi töötanud üldmudel GPT-6.1 Sol kirjutas lihtsama vormi piltide teksti täiesti õigesti ümber ligikaudu 54 protsendil juhtudest. Lühenditega vormi puhul oli tulemus vaid 11 protsenti.
Hindamine oli range: õigeks loeti vastus ainult siis, kui kogu pildi tekst kattus täpselt kontrolltekstiga. Üksainus vale märk tähendas, et vastus läks kirja ekslikuna. Need protsendid ei näita seega õigesti loetud tähtede osakaalu, vaid seda, kui sageli sai mudel hakkama ühegi veata.
Lugemist harjutati ka sõnadega, mida ei saanud ära arvata
Teadlased lõid lisatreeninguks ligikaudu 277 000 punktkirjapilti. Nad varieerisid punktide suurust ja vahesid, jäljendasid erinevat valgustust ning lisasid hägusust, müra ja perspektiivimoonutusi. Eesmärk oli tuua arvutis loodud harjutused lähemale ebatäiuslikele fotodele.
Umbes veerandis treeningtekstides olid tähed segamini, et mudel peaks sõnade äraarvamise asemel märke lugema. Päris punktkirjafotosid selles lisatreeningus ei kasutatud.
Nii õpetatud Qwen3.5-2B kirjutas lihtsama vormi pärispiltide teksti täiesti õigesti ümber 87 protsendil juhtudest. Lühenditega vormi puhul jõudis see 61 protsendini. Mõlemad tulemused ületasid kõigi katses eraldi töötanud üldmudelite omi.
Pilditöötlustööriistu kasutada saanud Claude Code saavutas lihtsamas osas pisut parema tulemuse, 88 protsenti, kuid lühenditega osas jäi 41 protsendi juurde. Tööriistadega süsteemidel kulus ühe pildi peale keskmiselt umbes kolm minutit. Ka ajakulu loeb, kui eesmärk on luua mugav igapäevane abiline.
Tehispiltidel hiilgamine võib anda petliku kindlustunde
Katse üks kõnekamaid võrdlusi puudutas varasema tehispildiandmestikuga treenitud Qweni. Sama päritolu sünteetilises kontrollkatses sai see 96 protsenti vastustest täiesti õigeks. BrailleBenchi lihtsama vormi pärispiltidel kukkus tulemus aga umbes kolme protsendini.
Arvutis loodud pildid võivad olla tõhus õppematerjal, kuid hea tulemus üht tüüpi tehispiltidel ei taga oskust lugeda päris silti või raamatulehekülge.
Ka uue mudeli tulemusi tuleb tõlgendada katse piirides. Lühenditega punktkirja osas oli ainult 44 pilti ning nende tekstid olid keskmiselt umbes kuus korda pikemad. Seetõttu ei saa täpselt eristada, kui palju raskendas lugemist lühendite kasutamine ja kui palju teksti pikkus. Ingliskeelse punktkirja katse ei tõenda ka mudeli oskust lugeda eestikeelset punktkirja.
Spetsiaalselt õpetatud mudeli vead olid enamasti väikesed, kuid „like to” asendamine sõnaga „cannot” näitab, miks üksnes vea suurusest ei piisa selle mõju hindamiseks. Kasulik punktkirjaluger peaks oskama ka märku anda, millal vastus vajab kontrollimist. Just siis saaks sellest abi inimesele, kes ise punktkirja ei tunne ega saa järele vaadata, kas tehisaru luges või arvas.
Artikkel valmis Yawni AI-agendi toimetamisel.